[비환급] [상위1% 빅데이터] 기업이 주목하는 Hadoop 제대로 배우기
과정소개
IT 대기업, 소셜 미디어 서비스 등에서 빅데이터 분석 및 처리에 하둡(Apache Hadoop)을 앞다투어 사용하고 있습니다. 하둡은 대량의 자료를 적은 비용으로 수집 및 가공처리할 수 있도록 만들어진 자바(Java) 언어 기반의 프레임워크로, 대규모 데이터 세트를 분산 저장하고 처리해 줍니다.
기업들은 데이터 분석을 통해 새로운 시장을 개척하고 희소성있는 가치를 부여하며, 소비자들에게 필요한 정보를 적기에 제공할 수 있게 될 겁니다. 중소기업 또한 빅데이터는 꼭 다뤄야 할 필수 사항인 만큼, 빅데이터 관련 직무로 취업/이직을 꿈꾸는 분들께는 희소식이 아닐 수 없습니다.
학습목표
빅데이터 용어에 대한 이해를 시작으로 HDFS, YARN 을 통한 하둡(Hadoop)의 Map Reduce 연산의 구현으로 빅 데이터를 다루는 과정을 직접 체험한다.
빅데이터 테크놀로지 (Big Data Technology) 중 데이터 수집/가공분야를 이해하게 되며, 이 과정이 결국은 빅데이터 분석가가 될 수 있다.
빅데이터 테크놀로지 (Big Data Technology) 중 데이터 수집/가공분야를 이해하게 되며, 이 과정이 결국은 빅데이터 분석가가 될 수 있다.
교재
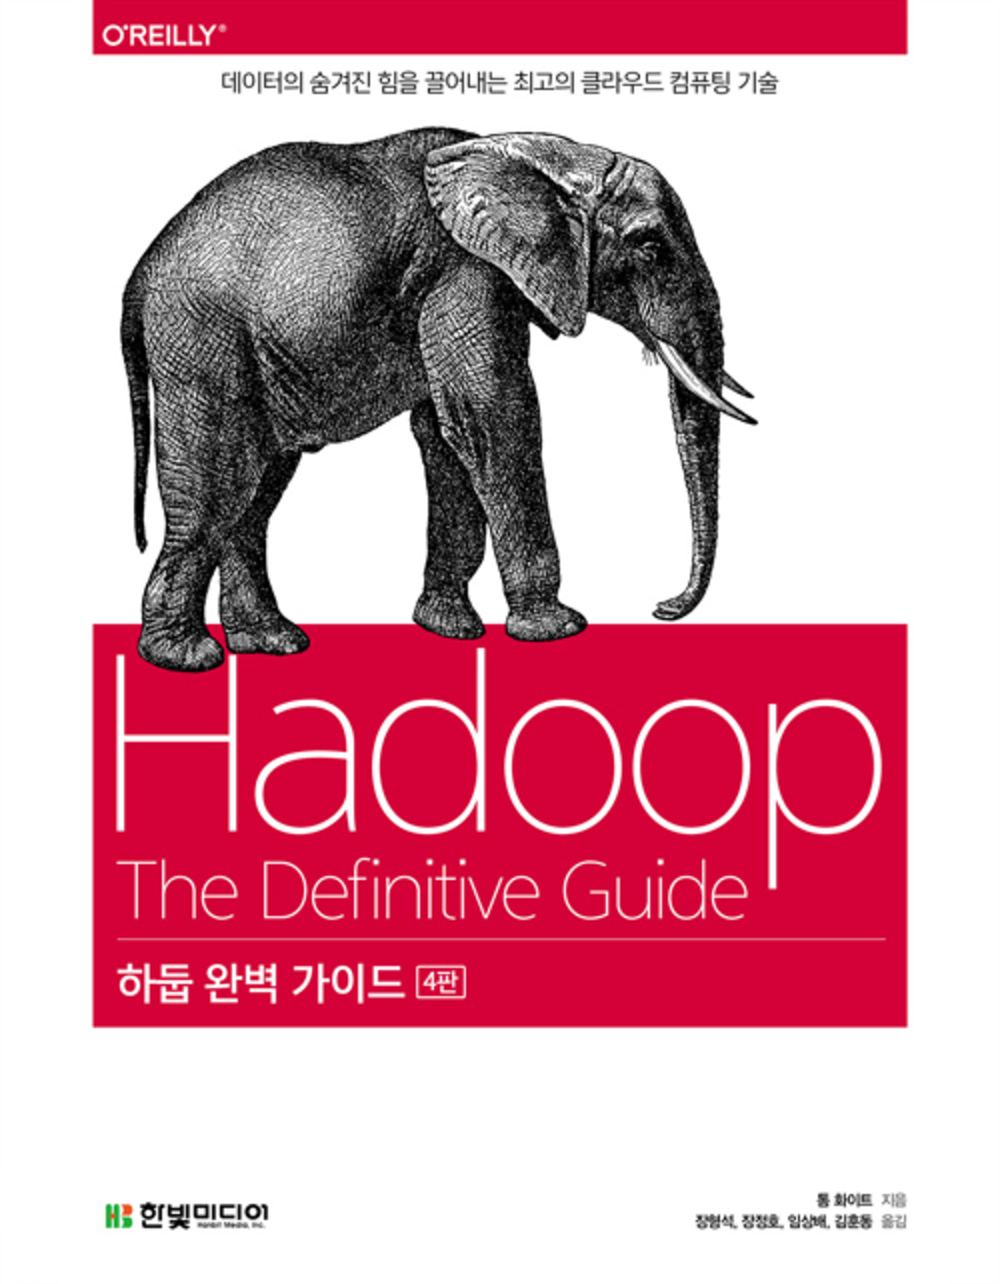
하둡 완벽 가이드
55,000원
하둡 프로젝트의 커미터이자 핵심 설계자인 톰 화이트가 집필한 이 책은 하둡 창시자인 더그 커팅을 비롯한 프로젝트별 전문가의 강력한 조언이 충실하게 반영되어 오랫동안 하둡 개발자의 바이블로서 자리를 지켜왔다. 이번 4판에서는 하둡 2.0 기반 YARN, 파케이, 플룸, 크런치, 스파크 프로젝트 예제와 헬스케어 시스템과 유전체 분석 사례가 새로이 추가되었다. 최신 하둡 정보는 물론이고 하둡과 연동하는 아파치 하둡 프로젝트의 서브 프로젝트인 피그, 주키퍼, HBase, 하이브, 스쿱, 에이브 등에 대해서도 다루기 때문에 하둡에 대한 전반적인 지식을 얻을 수 있다. 이 책은 대규모 데이터셋을 분석하는 개발자와 하둡 클러스터를 구축하고 사용하는 시스템 관리자를 위한 최고의 지침서가 될 것이다.
강의목차
| 차시 | 강의명 |
|---|---|
| 1차시 | Hadoop, HDFS 그리고 YARN |
| 2차시 | Linux 설치 및 환경설정 |
| 3차시 | Hadoop 설치 |
| 4차시 | Hadoop 실행 및 HDFS 명령어 |
| 5차시 | Map Reduce를 이용한 Word count 구현 1 |
| 6차시 | Map Reduce를 이용한 Word count 구현 2 |
| 7차시 | CDC COVID-19 데이터를 이용한 월별 확진자 통계 1 |
| 8차시 | CDC COVID-19 데이터를 이용한 월별 확진자 통계 2 |
| 9차시 | CDC COVID-19 데이터를 이용한 연령별 확진자 통계 |
| 10차시 | 사용자 정의 옵션 사용 1 |
| 11차시 | 사용자 정의 옵션 사용 2 |
| 12차시 | 사용자 정의 카운터 구현 1 |
| 13차시 | 사용자 정의 카운터 구현 2 |
| 14차시 | MultipleOutputs 구현 |
| 15차시 | 사용자 정렬 구현 1 |
| 16차시 | 사용자 정렬 구현 2 |
| 17차시 | HIve 소개 및 설치 |
| 18차시 | HiveQL을 이용한 Map Reduce 연산 1 |
| 19차시 | HiveQL을 이용한 Map Reduce 연산 2 |
| 20차시 | Hive Java Client |